20k Star:开源自托管的抖音 TikTok 数据 API,支持 MCP 接进 AI Agent
做内容分析、数据可视化、或者接 AI Agent 处理短视频数据的时候,第一个拦路虎就是数据怎么来。
抖音和 TikTok 都没有给普通开发者开放完整的数据 API。你想批量拉某个创作者的作品、分析评论情绪、做内容归档,要么手动一条条复制,要么用各种不稳定的第三方解析服务。第三方服务还有个问题:你的查询记录、cookie、数据都在别人服务器上。
Douyin TikTok Download API(简称 DTK)想把这个能力拿回自己手里。开源自托管,一套 REST API 加 MCP 加 CLI 加 Web Console,自己部署、自己管数据。20k Star,Apache 2.0 协议。
这是什么
DTK 是一个自托管的抖音和 TikTok 数据服务。它不是官方 API 的封装,而是通过逆向工程解析网页数据,提供结构化的接口。你部署在自己服务器上,数据存在自己的 PostgreSQL 里,查询记录只有自己知道。
v5 是当前主力版本,2026 年 9 月发布的 v5.1.0 是最新版。和早期的 v4 相比,v5 从根上重写了——从同步解析变成了异步任务系统,从手动配 cookie 变成了身份池管理,从只能解析视频链接变成了覆盖作品、作者、评论、搜索、合集的完整数据服务。
明确说一句:它不隶属于抖音或 TikTok 官方,也不使用 AI 去水印——它是在媒体地址解析层选择平台已经提供的干净媒体流。
四种接入方式
REST API。HTTP 请求到 /api/v1/...,适合脚本、后台服务、自动化流程。默认是异步的——发请求返回 HTTP 202 和一个 task_id,结果好了再取。也支持 ?wait=N 参数做同步等待(最多 30 秒),方便简单调用。
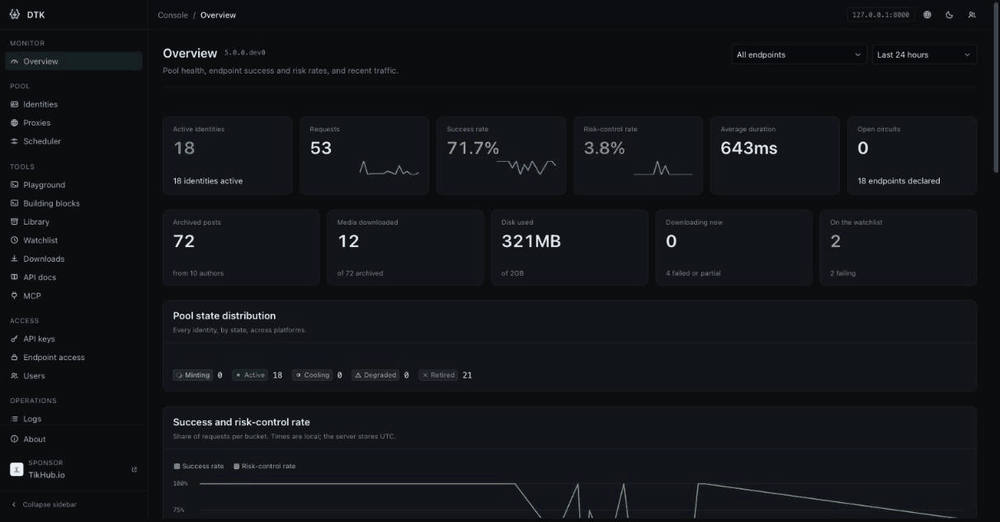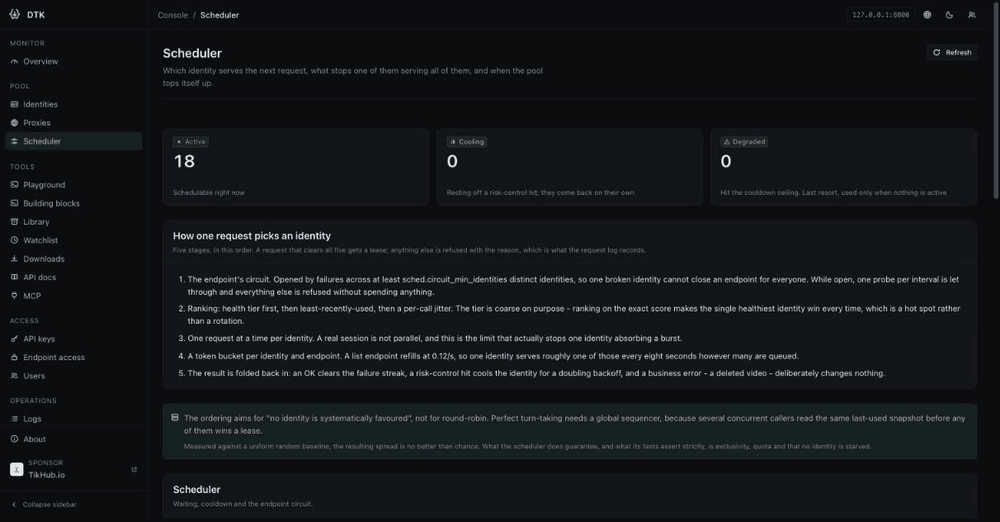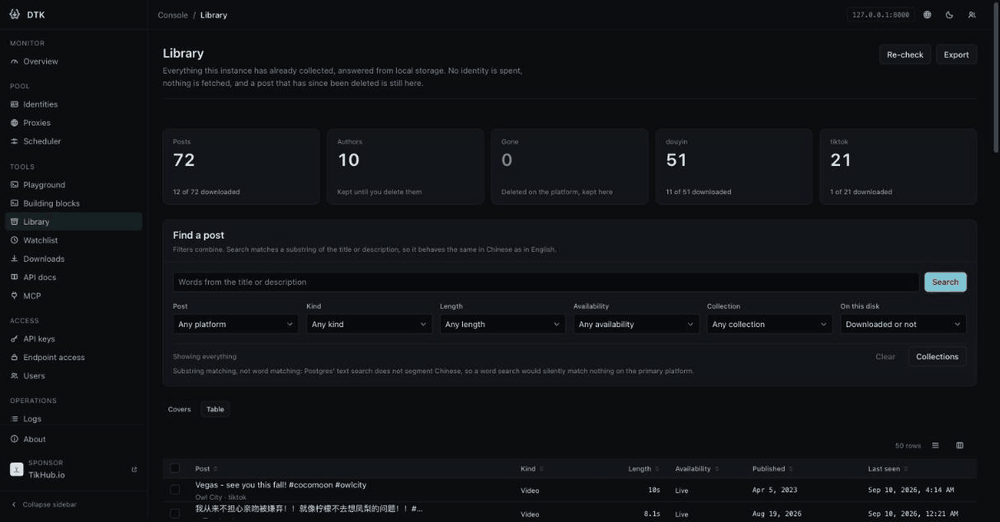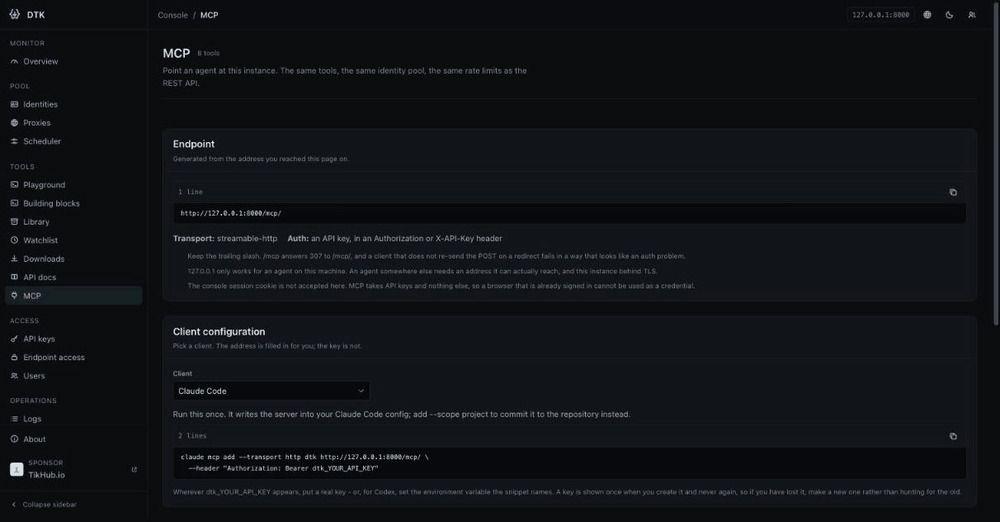
MCP 服务。这是它和 AI Agent 生态对接的关键。/mcp 端点可以直接连 Claude Code、Claude Desktop、Codex CLI 这些支持 MCP 的客户端。连上之后,AI 助手就能通过 MCP 协议调用 DTK 的能力——搜作品、拉评论、解析媒体——不需要你手动复制数据喂给 AI。
CLI 工具。dtk 命令行,终端里直接用,适合临时查询或写 shell 脚本。
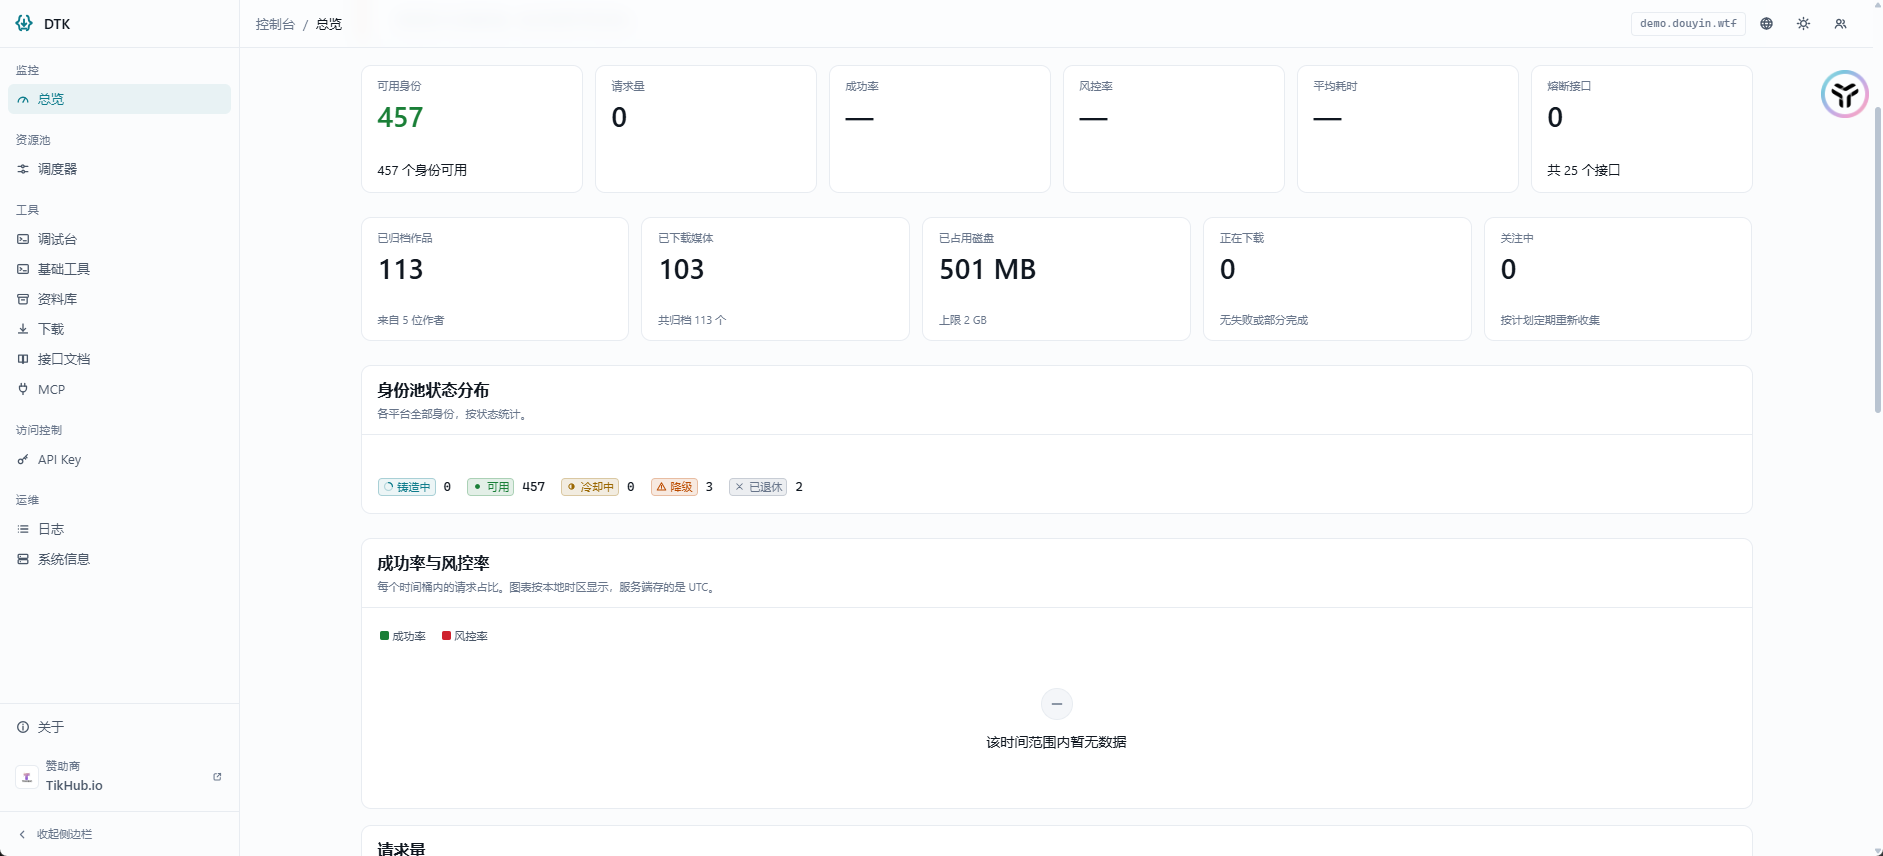
Web Console。React 写的管理界面,中英双语。身份池管理、调度器状态、数据仓库、下载列表、日志、API Key 管理,都在这个界面里操作。
能拉哪些数据
数据覆盖面相当完整。
作品数据。单个视频作品和图集作品都能拉,包括标题、描述、点赞数、评论数、媒体地址等。
作者数据。公开主页信息、作品列表、点赞列表。v5.1.0 新增了作者收藏/合集列表。关注者和被关注列表需要登录会话才能取。
评论数据。评论和评论回复都能拉,适合做情绪分析、热词统计。
搜索。关键词搜索作品,适合做内容趋势分析、竞品监控。
合集和播放列表。合集里的作品、播放列表内容。
媒体解析。无水印视频流选择——前面说过,不是 AI 去水印,是选择平台已提供的干净媒体流。
归档数据。解析过的数据存在 PostgreSQL 里,即使上游内容后来被删除,本地归档的数据还在。
身份池和任务系统
v5 相比 v4 最大的升级是身份池。
v4 时代,你要手动配 cookie,一个 cookie 用坏了就手动换。v5 把身份管理做成了池子——管理多个 cookie、浏览器环境、会话状态,带健康监控、优先级调整、每个身份每个端点的限速、接口级熔断。身份不够用时,还可以选配 CloakBrowser 组件自动生成访客身份。
任务系统也是新的。默认异步执行,返回 task_id 后台跑,不阻塞调用方。调度器负责身份健康跟踪、身份轮换、独占锁、限速、熔断、结构化请求日志。这套设计让 DTK 能扛住一定的并发量,而不是一个请求一个请求排队。
本地数据归档
解析过的数据存在 PostgreSQL(带 TimescaleDB)里,Redis 做缓存和队列。这意味着你拉过的数据会留在自己数据库里,形成本地数据仓库。
对于做内容研究、趋势分析的人来说,这很有价值。你可以定期拉某个创作者的作品列表,积累一段时间后,就有了一个自建的内容数据库,可以做时间序列分析、传播规律研究。即使原内容在平台上被删除或修改,你本地的归档还在。
怎么部署
Docker Compose 是推荐的部署方式。
git clone https://github.com/Evil0ctal/Douyin_TikTok_Download_API.git
cd Douyin_TikTok_Download_API
cp .env.example .env
# 配置 DTK_SECRET_KEY、PostgreSQL、Redis 凭据
docker compose -p dtk -f docker/compose.yml up -d --wait --wait-timeout 300
默认 API 绑定 127.0.0.1:8000。核心服务四个:API、Worker、PostgreSQL、Redis。CloakBrowser 组件可选,不装也能用基本功能。
技术栈:Python 3.12 + FastAPI 后端,React 19 + TypeScript 前端,Go 1.23 写的下载 sidecar。不需要 Kafka、Elasticsearch、对象存储、Kubernetes,部署门槛比想象中低。
REST API 调用示例:
curl -sS -X POST 'http://127.0.0.1:8000/api/v1/parse?wait=25' \
  -H "X-API-Key: ${API_KEY}" \
  -H 'content-type: application/json' \
  -d '{"url":"你的抖音或TikTok分享链接"}'
合规提醒
这个项目需要单独说一下合规。
它是第三方逆向工程方案,不隶属于抖音或 TikTok 官方。自托管不等于规避平台风控——平台对数据抓取有自己的限速和风险控制机制,DTK 的身份池和限速设计是为了在平台规则内更稳定地工作,不是为了突破限制。
数据抓取可能涉及平台的使用条款和法律法规。部署前评估你的使用场景是否符合平台规则和当地法律。Apache 2.0 协议覆盖的是源代码,不授予数据抓取或再分发的权利。
官方 demo 实例(demo.douyin.wtf)有限速(10 秒内 30 请求,10 秒冷却),是共享实例,可能随时重置或暂停,不要在上面提交个人 cookie 或敏感凭据。
适合什么人
如果你符合这几条,DTK 值得看看:需要批量获取抖音或 TikTok 的内容数据;想接进 AI Agent 工作流,让 AI 助手能查短视频数据;做内容分析、趋势研究、竞品监控;想要自托管、数据在自己手里的方案;有 Docker 部署能力。
几个提醒。Douyin 的关注/被关注列表需要登录会话。v4 支持的 Bilibili 没有迁移到 v5。小红书、快手、微博不支持。技术栈是 Python + Go,不依赖重量级中间件。20k Star,社区活跃。
获取方式:GitHub 仓库 github.com/Evil0ctal/Douyin_TikTok_Download_API ,文档站 douyin.wtf。
把短视频数据接口握在自己手里,接进 AI Agent 的工作流,这件事 20k Star 说明不少开发者有这个需求。开源、自托管、数据不出自己服务器,是这个项目的价值所在。
关注「善忘技术夹」全媒体矩阵
扫描上方宣传海报二维码,第一时间获取最新技术文章、开源项目与免安装小程序体验。